JPA 로 테이블을 설계하다 보면 한 번씩 여기서 막힌다. PK 전략 비교가 필요한 지점이다.
“PK 그냥 Long auto increment 쓰면 되는 거 아닌가” 싶은데 찾아보면 UUID 도 있고 시퀀셜 UUID 도 있고 @Tsid 라는 것도 있다.
처음엔 “숫자면 되지 뭐가 이렇게 많나” 했는데, MSA 환경에서 PK 가 겹치는 사고를 한 번 겪고 나서 생각이 바뀌었다.
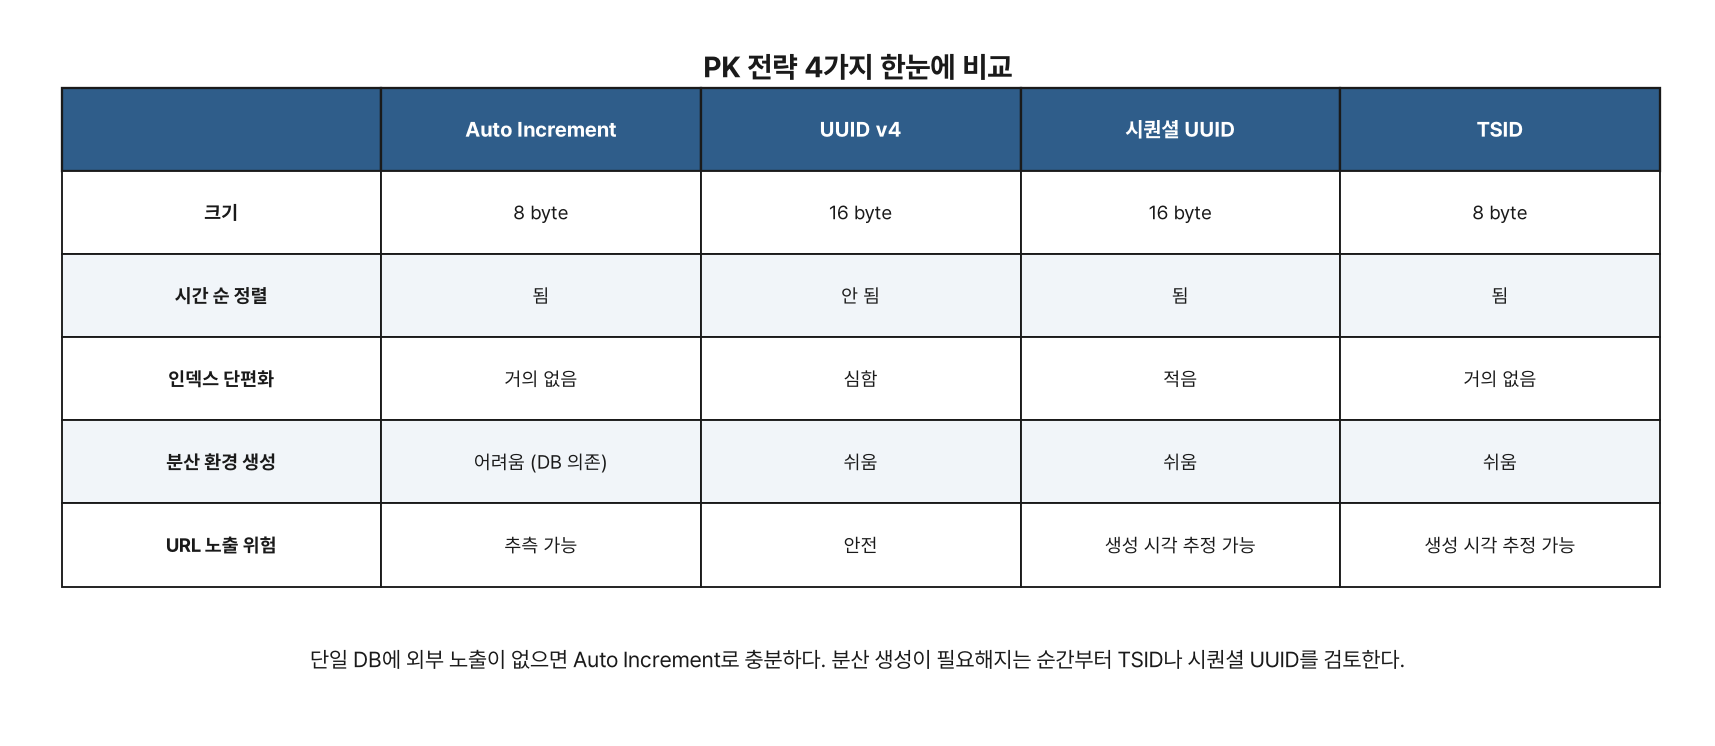
PK 전략 비교 — 각각 뭐가 다른가
Auto Increment (IDENTITY/SEQUENCE) — DB 가 1씩 올려주는 가장 익숙한 방식이다. 인덱스 효율이 제일 좋고 정렬도 완벽하다.
대신 단일 DB 에 종속돼서 샤딩하거나 서버 여러 대에서 동시에 발급하면 답이 없다. URL 에 /orders/1234 로 노출되면 다음 번호를 찍어보는 순차 조회도 가능해진다.
UUID(v4) — 랜덤이라 전역 유일성은 완벽하다.
문제는 B+Tree 인덱스에 랜덤 값이 계속 끼어들면서 페이지 스플릿이 대량으로 일어난다는 것이다. 데이터가 몇백만 건 쌓이고 나서 insert 가 느려진다.
시퀀셜 UUID (UUIDv7 등) — 앞부분이 타임스탬프고 뒷부분만 랜덤이라 정렬성이 생긴다. 유일성은 유지하면서 인덱스 스플릿 문제를 줄여준다.
@Tsid: Vlad Mihalcea가 만든 hypersistence-utils 라이브러리 기능인데,
64비트 Long 안에 타임스탬프+노드ID+카운터를 욱여넣어서 시간순 정렬되는 정수 PK를 뽑아줍니다.
UUID 처럼 16바이트를 안 먹고 BIGINT 8바이트로 끝나서 인덱스가 가볍고 분산 환경에서도 안전하다.
@Entity
public class Order {
    @Id
    @Tsid
    private Long id;
}
UUID가 인덱스를 망가뜨리는 진짜 이유
“UUID 쓰면 느려진다” 는 말은 흔한데 왜 느려지는지는 잘 안 짚는다. 두 가지가 겹친다.
첫째, 삽입 위치가 랜덤이다. InnoDB 는 클러스터형 인덱스라 PK 순서대로 데이터를 물리적으로 정렬해 저장한다.
Auto Increment 면 항상 맨 뒤에 붙어서 마지막 페이지만 건드리면 끝난다. UUID v4 는 값이 랜덤이라 B+Tree 한가운데에 꽂힌다.
그 페이지가 꽉 차 있으면 페이지를 쪼개야 하고(페이지 스플릿), 이게 데이터 쌓일수록 계속 일어나요.
버퍼 풀에 없는 페이지를 매번 디스크에서 읽어야 하는 것도 따라온다.
둘째, 보조 인덱스가 전부 같이 뚱뚱해져요. InnoDB 보조 인덱스의 리프에는 PK 값이 통째로 들어갑니다. 그러니까 PK가 8바이트냐 16바이트냐 36바이트냐에 따라 테이블에 걸린 모든 인덱스의 크기가 같이 움직여요.
UUID 를 그냥 String 으로 매핑하면 CHAR(36) 으로 잡혀 인덱스가 네 배 이상 커진다.
UUID 를 쓸 거면 최소한 바이너리로 저장하게 매핑하는 것부터 챙겨야 한다.
실무에서는 뭘 쓰나
트래픽이 적고 단일 서버로 끝나는 프로젝트에 UUID 나 TSID 를 쓸 이유는 없다. 오버엔지니어링이다.
MSA 로 쪼개서 여러 서비스가 동시에 ID 를 발급하거나 PK 를 그대로 API 응답에 노출하는 구조라면 얘기가 다릅니다.
분산환경 기본키 채번 전략 정리 글에도 나오지만,
정렬성·유일성·크기를 다 챙기려면 TSID 가 현실적인 선택지다.
코드로 보면
// 1. Auto Increment — 단일 DB면 이게 여전히 정답
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;

// 2. UUID — 반드시 UUID 타입으로 매핑할 것 (String으로 두면 CHAR(36))
@Id
@GeneratedValue
private UUID id;

// 3. 시간 정렬되는 UUID — Hibernate 6의 @UuidGenerator
@Id
@GeneratedValue
@UuidGenerator(style = UuidGenerator.Style.TIME)
private UUID id;

// 4. TSID — Long 8바이트에 시간 정렬까지
@Id
@Tsid
private Long id;
3번은 주의할 게 하나 있다.
Hibernate의 Style.TIME은 시간 기반 UUID를 만들어주긴 하는데, RFC 9562의 UUIDv7과 정확히 같은 형식은 아닙니다. 엄밀하게 v7 스펙이 필요하면(다른 시스템과 형식을 맞춰야 한다든가) 별도 생성기를 붙이는 게 일반적이에요.
“인덱스 친화적인 정렬성” 만 필요하면 Style.TIME 으로 충분하다.
이미 Auto Increment로 만들어버렸다면
여기가 제일 현실적인 고민일 것이다.
결론부터 말하면 PK 타입 변경은 웬만하면 하지 않는다. 그 PK 를 참조하는 FK 가 걸린 테이블을 전부 같이 바꿔야 해서 사실상 테이블 재생성 + 전체 마이그레이션이 된다. 서비스가 돌아가는 중에 할 일이 아니다.
대신 절충안이 있습니다.
PK는 Auto Increment 그대로 두고, 외부 노출용 식별자 컬럼을 따로 하나 추가하는 것입니다.
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;          // 내부용 — 조인, FK, 인덱스 전부 이걸로

@Column(unique = true, updatable = false)
private UUID publicId;    // 외부용 — API 응답과 URL엔 이것만 나감
이러면 조인과 인덱스 성능은 BIGINT 그대로 챙기면서 /orders/1234 같은 순번 노출만 없앨 수 있다. 마이그레이션 비용도 컬럼 하나 추가와 백필이라 훨씬 싸다.
정리
- 단일 DB 모놀리식이면 Auto Increment가 여전히 정답이에요. 다른 걸 쓸 이유를 먼저 찾으세요.
- UUID v4는 유일성은 완벽하지만 정렬성이 없어서 인덱스에 제일 나쁩니다. 쓸 거면 최소한 바이너리로 저장하세요.
- 분산 환경이면 시퀀셜 UUID나 TSID로. 크기까지 아끼고 싶으면 TSID(8바이트)가 유리해요.
- 이미 만든 테이블의 PK는 바꾸지 말고, 노출용 식별자 컬럼을 따로 추가하는 쪽이 훨씬 쌉니다.
“무조건 이거 써라” 가 아니라 서비스 규모와 분산 여부를 보고 고르는 문제다.
처음엔 전부 UUID 로 통일하고 싶었는데, 인덱스가 터지는 걸 한 번 겪고 나서 정렬 안 되는 랜덤 PK 는 조심해서 쓰게 됐다.