N+1 만 계속 팠는데, JPA 를 쓰면서 그보다 무서울 수 있는 게 하나 있다. JPA OSIV(Open Session In View)다.
이름만 들으면 뭘 하는 건지 감이 안 오는데, 스프링 부트를 쓰는 순간 기본값으로 켜져 있는 옵션이라 모르고 쓰는 경우가 많다.
JPA OSIV가 뭐길래
원래 JPA 는 트랜잭션이 끝나면 영속성 컨텍스트도 같이 닫힌다. 그래서 트랜잭션 밖(Controller 나 View)에서 지연 로딩 필드에 접근하면 LazyInitializationException 이 터지는 게 정상이다.
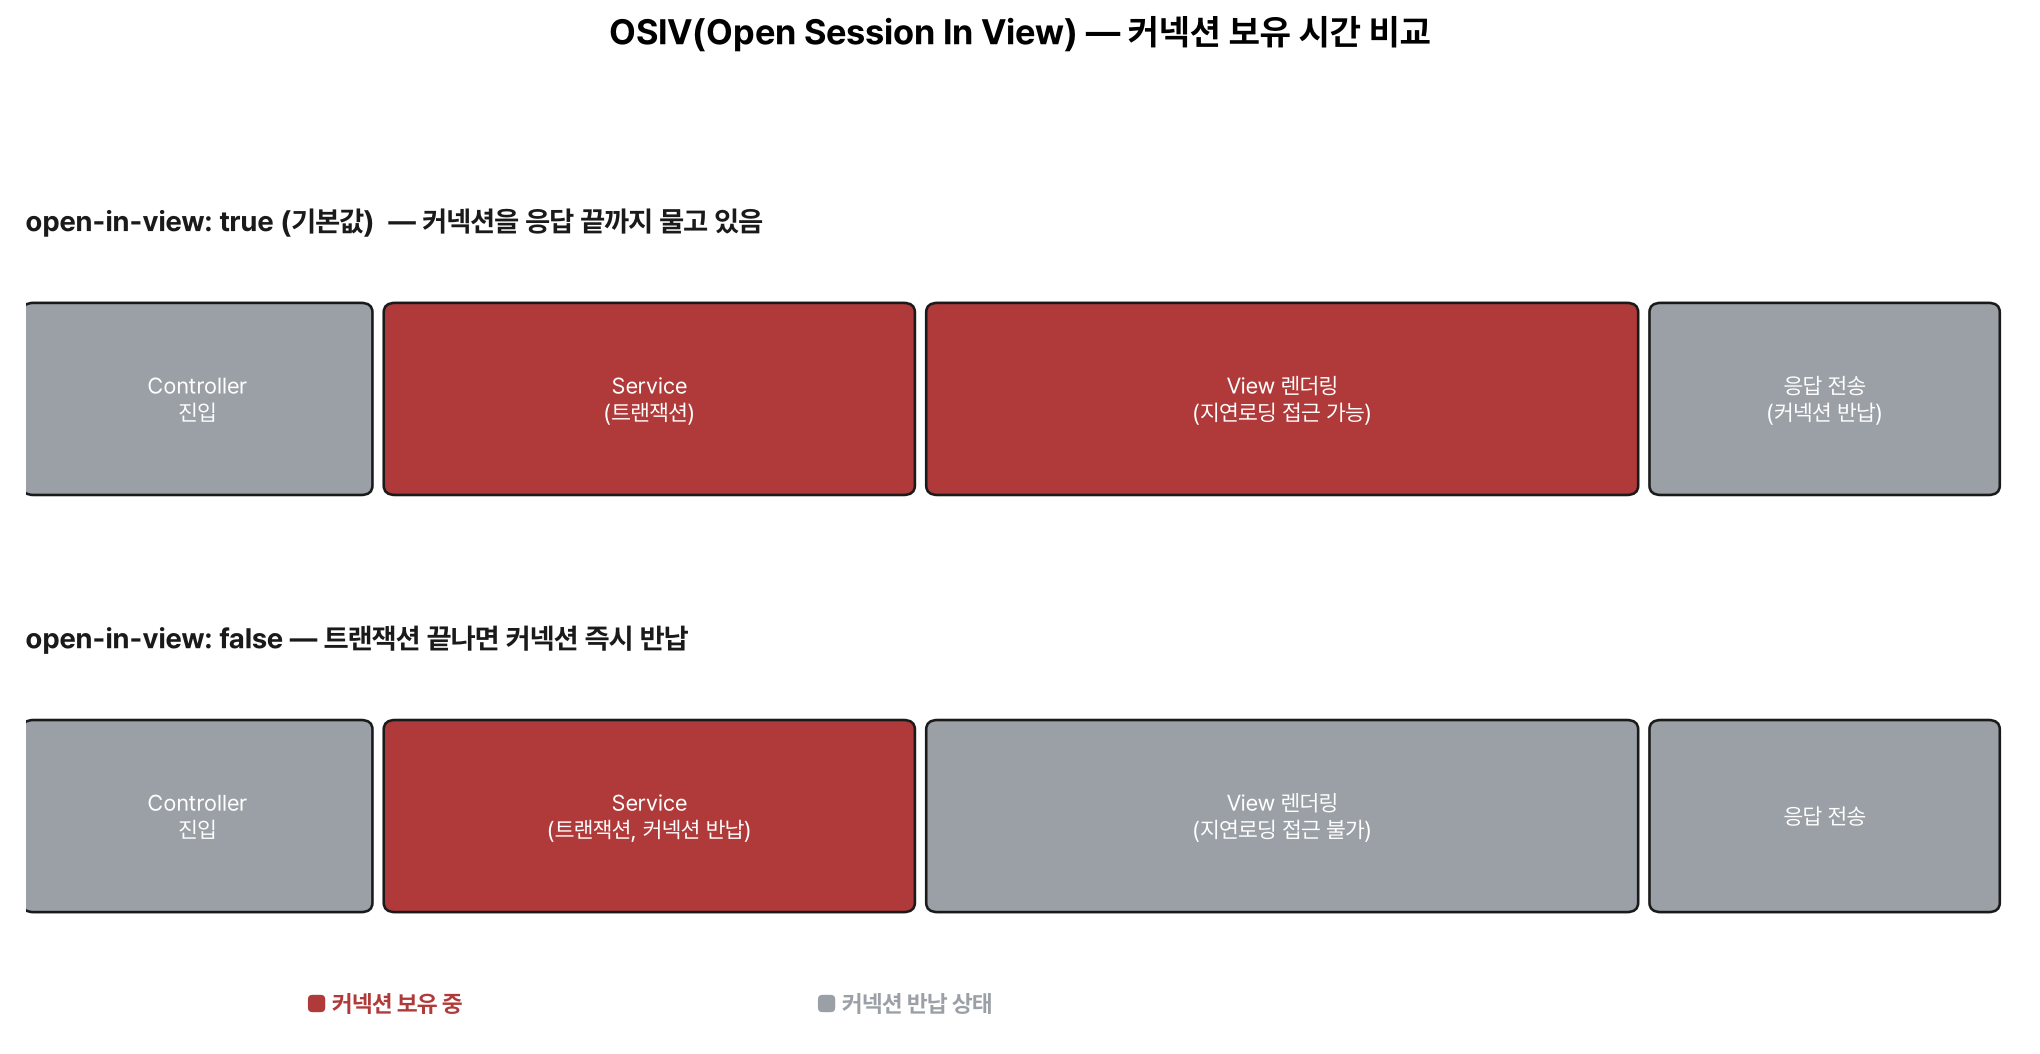
그런데 스프링 부트는 spring.jpa.open-in-view 기본값이 true 라, 트랜잭션이 끝나도 영속성 컨텍스트를 요청-응답 끝까지 살려둔다.
Controller 에서도 View 렌더링 중에도 지연 로딩이 동작하는 이유다. 편해서 별생각 없이 써온 부분이다.
근데 이게 왜 무서운 거냐면
편한 대신 대가가 있다.
영속성 컨텍스트가 살아 있다는 건 DB 커넥션도 그만큼 오래 물고 있다는 뜻이다. Service 로직이 끝나고 View 를 그리는 데 시간이 걸리면 그동안에도 커넥션 하나가 붙잡혀 있습니다.
트래픽이 적을 땐 티가 안 난다. 요청이 몰리면 달라진다.
커넥션 풀은 한정돼 있는데 다들 뷰 렌더링이 끝날 때까지 커넥션을 안 놔준다. 풀이 고갈되고 나머지 요청은 줄줄이 대기하다 장애가 된다.
HikariCP 기본 풀 사이즈가 10이다. 뷰 렌더링이 느린 API 하나가 동시에 20~30개 요청을 받으면 나머지는 전부 대기 상태로 빠진다.
터졌을 때 어떻게 알아보나
원인 찾는 데 한참 걸리는 종류의 문제다. 이유가 있습니다.
커넥션 풀은 모든 API 가 같이 쓰는 자원이다. 느린 API 하나가 커넥션을 오래 물고 있으면 그 API 만 느려지는 게 아니라 아무 상관 없는 다른 API 까지 같이 죽는다.
장애 초기에 증상이 사방에서 올라오는 이유다. 로그인이 안 된다, 목록이 안 뜬다, 저장이 실패한다. 정작 범인은 조용히 뷰를 렌더링 중인 API 하나다.
로그 — 예외 메시지에 이미 답이 들어 있어요
커넥션을 못 받으면 HikariCP 가 이 예외를 던진다.
java.sql.SQLTransientConnectionException: HikariPool-1 - Connection is not available,
request timed out after 30001ms (total=10, active=10, idle=0, waiting=17)
여기서 두 가지를 놓치기 쉽다.
첫째, 30초는 쿼리 시간이 아니다. connection-timeout 기본값이 30000ms 고, “커넥션을 30초 기다렸는데 못 받았다” 는 뜻이다. 쿼리가 느린 걸로 오해하면 슬로우 쿼리 로그를 뒤지느라 시간을 버린다.
둘째, 괄호 안이 진단 그 자체다. active 가 total 과 같고 idle=0 이면 풀이 바닥난 것이고, waiting=17 은 그 뒤에 17개 스레드가 줄 서 있다는 뜻이다.
풀 상태를 주기적으로 보고 싶으면 로그 레벨을 올리면 됩니다.
logging:
  level:
    com.zaxxer.hikari.pool.HikariPool: DEBUG
HikariPool-1 - Pool stats (total=10/10, idle=0/10, active=10, waiting=17)
터지고 나서가 아니라 터지기 전에 waiting 이 올라가는 게 보이면 그게 예고편이다.
지표 — 이 세 개만 보면 돼요
액추에이터를 쓰고 있다면 이 세 개를 본다.
hikaricp.connections.active 는 지금 쓰이는 커넥션, hikaricp.connections.pending 은 커넥션을 못 받고 대기 중인 스레드, hikaricp.connections.timeout 은 기다리다 실패한 누적 횟수다.
평상시 pending 은 0이어야 정상이다. 0이 아닌 구간이 잠깐이라도 보이면 이미 아슬아슬한 것이다. 트래픽이 조금만 더 오면 넘어갑니다.
안 겪어봤으면 재현이라도 해보세요
로컬에서 만들 수 있다. 풀을 작게 잡고 타임아웃을 짧게 주면 금방 본다.
spring:
  jpa:
    open-in-view: true
  datasource:
    hikari:
      maximum-pool-size: 5
      connection-timeout: 3000
컨트롤러가 엔티티를 그대로 리턴하게 두고(직렬화하면서 지연 로딩이 걸리게), 동시 요청을 풀 크기보다 많이 던지면 된다.
ab -n 200 -c 20 http://localhost:8080/orders/1
그다음 아래 “고치는 방향” 대로 fetch join + DTO 변환까지 해두고 open-in-view: false 로 바꿔 같은 부하를 준다. waiting 숫자가 어떻게 달라지는지 직접 보면 된다.
지금 내 프로젝트는 켜져 있나
확인은 간단하다. 스프링 부트는 이 옵션을 명시하지 않으면 애플리케이션이 뜰 때 경고 로그를 찍는다.
WARN  JpaBaseConfiguration$JpaWebConfiguration :
spring.jpa.open-in-view is enabled by default. Therefore, database queries
may be performed during view rendering. Explicitly configure
spring.jpa.open-in-view to disable this warning
이 로그를 그동안 넘겼다면 지금 켜져 있는 것이다. 값을 명시하면 경고도 같이 사라집니다.
# application.yml
spring:
  jpa:
    open-in-view: false   # 켤 거면 true라고 명시해두는 게 낫다
끄든 켜든 값은 적어둔다. 기본값에 기대고 있으면 나중에 누가 봐도 의도한 건지 모르고 둔 건지 알 수가 없다.
그럼 무조건 꺼야 하나
spring.jpa.open-in-view: false 로 끄면 이 문제는 해결된다. 공짜는 아니다.
끄는 순간 트랜잭션이 Service 계층에서 끝나서, Controller 나 View 에서 지연 로딩 필드를 건드리면 바로 LazyInitializationException 이 난다.
실제로 터지는 코드를 보자.
// Service — 트랜잭션이 여기서 끝난다
@Transactional(readOnly = true)
public Order findOrder(Long id) {
    return orderRepository.findById(id).orElseThrow();
}

// Controller — 트랜잭션 밖
@GetMapping("/orders/{id}")
public OrderResponse get(@PathVariable Long id) {
    Order order = orderService.findOrder(id);
    // OSIV를 끄면 여기서 LazyInitializationException
    return new OrderResponse(order.getMember().getName());
}
order.getMember() 가 지연 로딩인데 트랜잭션이 이미 닫혀서 프록시를 초기화할 방법이 없다.
OSIV 가 켜져 있을 땐 영속성 컨텍스트가 살아 있으니 조용히 쿼리가 하나 더 나가면서 넘어갔던 부분입니다.
즉 OSIV는 이 문제를 해결해준 게 아니라 가려주고 있었던 겁니다
고치는 방향은 트랜잭션 안에서 필요한 걸 다 끝내는 것이다.
// 1) 필요한 연관관계를 fetch join으로 한 번에 가져오고
@Query("select o from Order o join fetch o.member where o.id = :id")
Optional<Order> findWithMember(@Param("id") Long id);

// 2) 트랜잭션 안에서 DTO로 변환까지 끝내고 반환한다
@Transactional(readOnly = true)
public OrderResponse findOrder(Long id) {
    Order order = orderRepository.findWithMember(id).orElseThrow();
    return new OrderResponse(order.getMember().getName());
}
이제 Controller 는 완성된 DTO 만 받으니 지연 로딩을 건드릴 일이 없다.
컨트롤러가 엔티티를 직접 리턴하지 않는다는 원칙 하나만 지켜도 OSIV 를 꺼서 생기는 문제는 대부분 사라진다.
여기서 쓰는 무기가 4편에서 다룬 N+1 해결법과 똑같다. fetch join 과 batch_fetch_size 가 그대로 쓰인다.
OSIV를 끌 수 있는 상태 = N+1을 통제하고 있는 상태라고 봐도 크게 틀리지 않습니다.
실무 판단 기준
- 트래픽이 적고 내부 관리자 페이지처럼 커넥션 경합이 걱정 없는 서비스 → 굳이 안 꺼도 큰 문제는 없음
- 트래픽이 많거나 API 응답 지연이 발생하는 서비스 → false로 끄는 게 정석. 대신 서비스 계층에서 DTO 변환까지 책임지는 구조로 미리 정리해둬야 함
- 둘 중 뭘 고를지 애매하면, 일단 켜둔 채로 개발하다가 배포 직전 트래픽 테스트에서 커넥션 풀 사용량을 모니터링해보고 결정하는 것도 방법
정리
- OSIV는 스프링 부트 기본값 true, 트랜잭션 끝나도 영속성 컨텍스트를 응답 끝까지 살려두는 옵션
- 편하긴 한데 그만큼 DB 커넥션을 오래 붙잡고 있어서 트래픽 몰리면 커넥션 풀 고갈로 장애 날 수 있음
- 트래픽 많은 서비스라면 false로 끄고, 대신 Service 계층에서 필요한 데이터 다 끌어와서 DTO로 반환하는 습관이 안전함