이번엔 N+1 문제다. JPA N+1 문제 해결 방법을 하나씩 확인해본다.
처음 겪었을 때 “쿼리 하나만 날렸는데 로그에 왜 SELECT 가 우르르 찍히지” 하면서 한참 헤맸다.
N+1이 도대체 왜 터지는 거냐면
원인은 단순하다.
연관관계가 있는 엔티티를 조회할 때, 부모를 가져오는 쿼리 1번에 자식을 각각 따로 조회하는 쿼리가 N번 더 나간다.
List<Team> teams = teamRepository.findAll(); // 쿼리 1번

for (Team team : teams) {
    System.out.println(team.getMembers().size()); // team마다 쿼리 발생!
}
직접 돌려봤다. 팀 3개에 회원을 2명씩 넣고 위 코드를 실행한 로그다.
select t1_0.id, t1_0.name
from team t1_0                       -- ① 팀 조회, 1번

select m1_0.team_id, m1_0.id, m1_0.age, m1_0.email, m1_0.name
from member m1_0 where m1_0.team_id=?   -- ② 팀1의 회원
팀 팀1 회원 수: 2

select m1_0.team_id, m1_0.id, m1_0.age, m1_0.email, m1_0.name
from member m1_0 where m1_0.team_id=?   -- ③ 팀2의 회원
팀 팀2 회원 수: 2

select m1_0.team_id, m1_0.id, m1_0.age, m1_0.email, m1_0.name
from member m1_0 where m1_0.team_id=?   -- ④ 팀3의 회원
팀 팀3 회원 수: 2
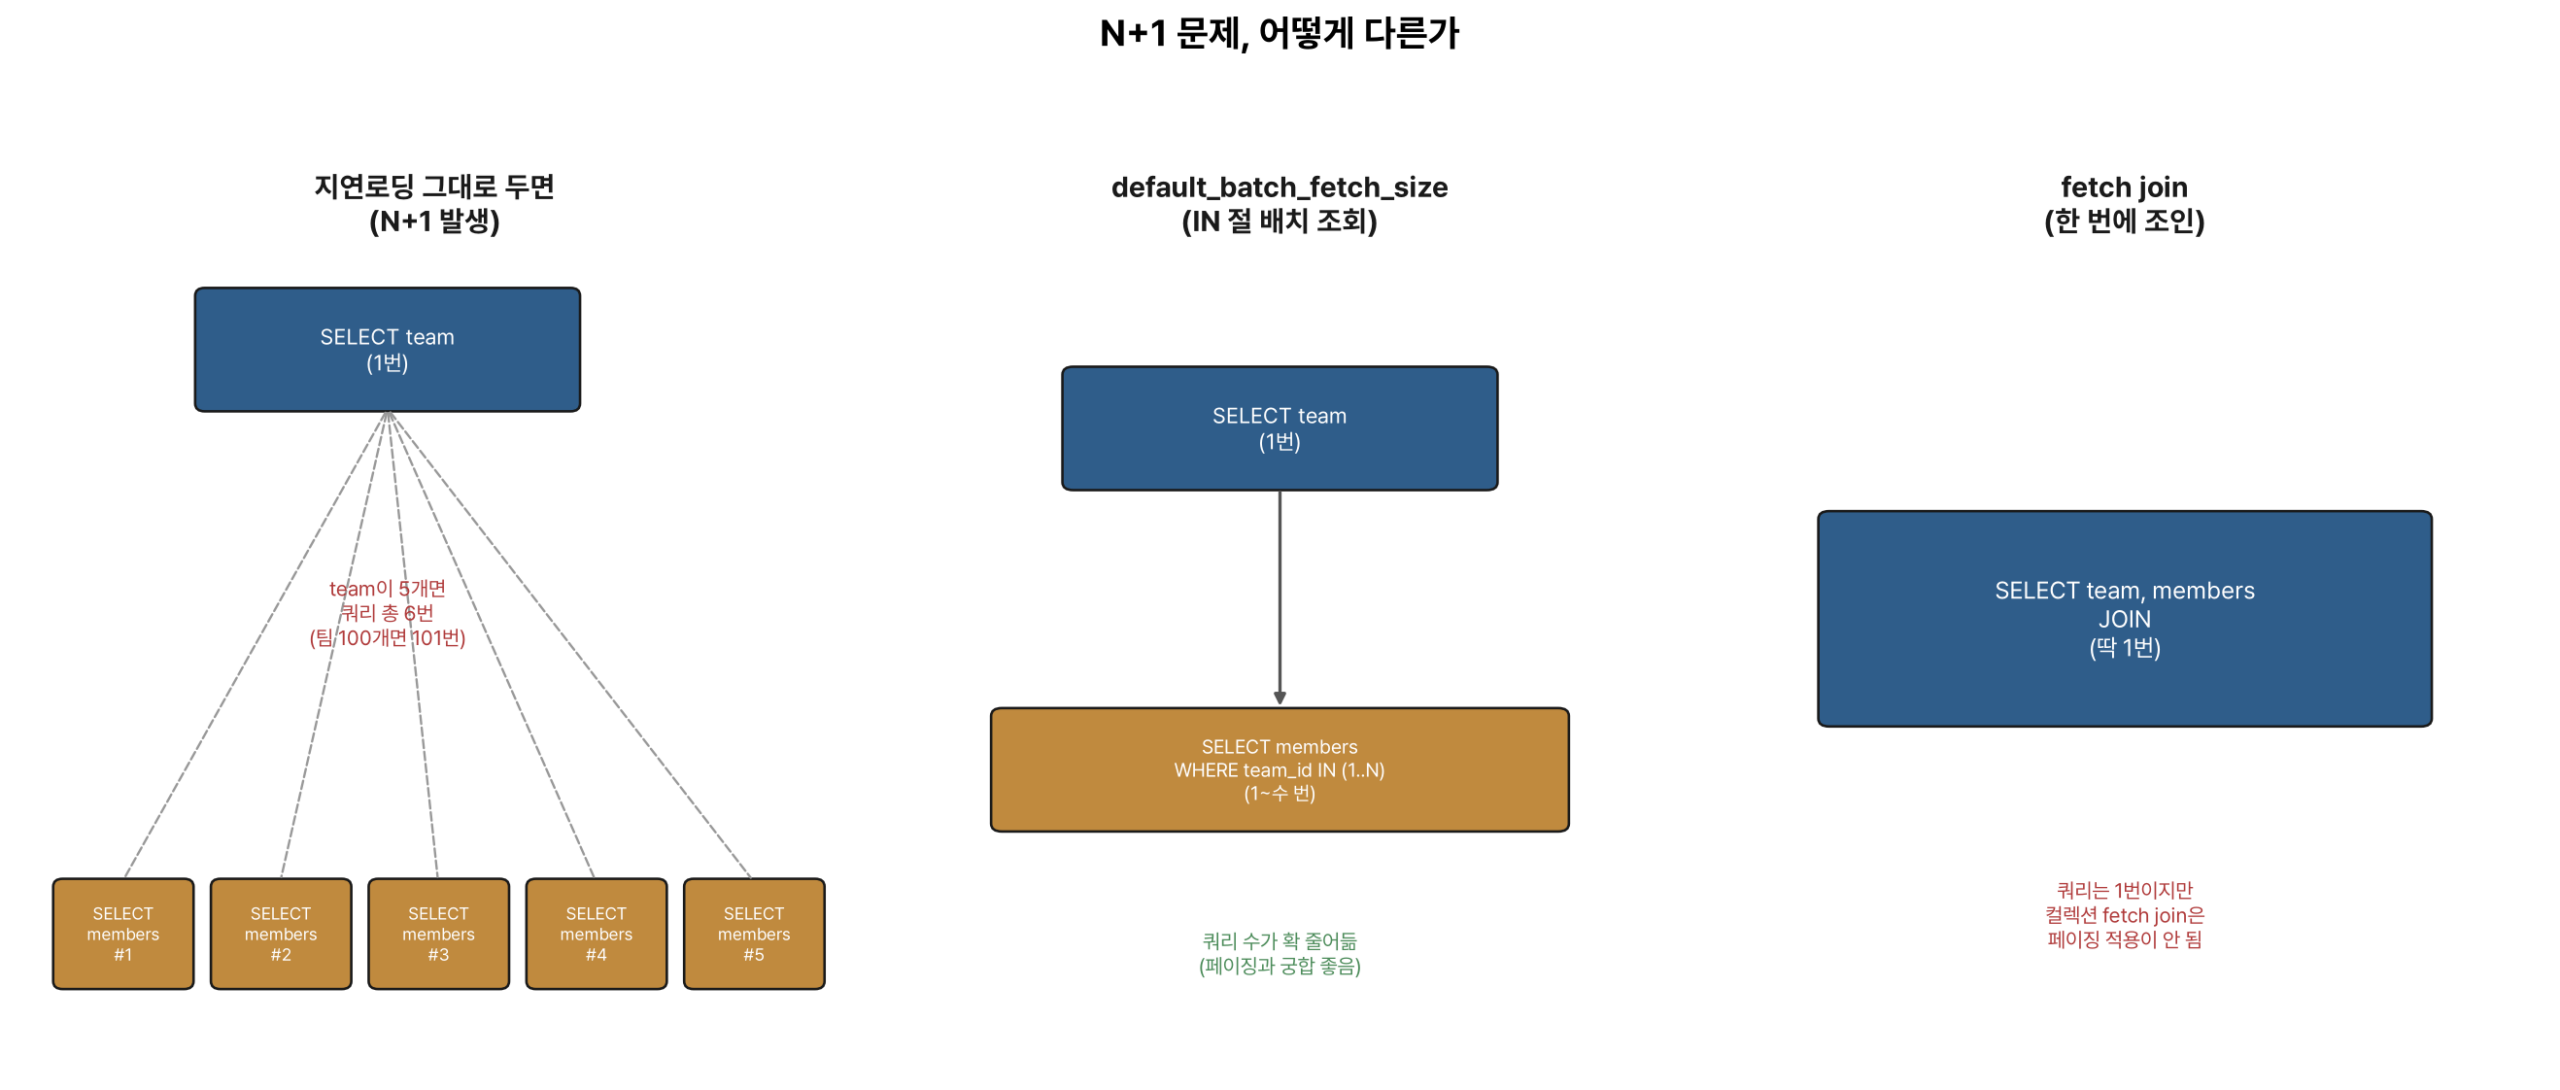
팀이 3개인데 쿼리가 4번 나갔다. 1(팀) + 3(팀마다 회원)이다.
Team 이 10개면 findAll() 1번 + 지연로딩 10번 = 11번이다. 100개, 1000개로 늘어나면 그대로 비례한다.
2편에서 다룬 영속성 컨텍스트는 트랜잭션 하나 안의 얘기라, 컬렉션을 순회하며 지연로딩을 건드릴 때마다 새 쿼리가 나가는 건 못 막는다.
JPA N+1 문제 해결 1 — yml에 batch_fetch_size 한 줄 추가하기
제일 간단하고 효과가 좋다. application.yml 에 한 줄만 추가하면 된다.
spring:
  jpa:
    properties:
      hibernate:
        default_batch_fetch_size: 100
지연로딩 대상을 하나씩 조회하는 대신 IN 절로 묶어서 가져온다.
team 이 100개여도 members 조회가 100번이 아니라 WHERE team_id IN (...) 으로 한 번, 혹은 batch size 에 맞춰 몇 번만 나갑니다.
같은 코드를 default_batch_fetch_size: 10 으로 켜고 다시 돌린 로그다.
select t1_0.id, t1_0.name
from team t1_0                       -- ① 팀 조회

select m1_0.team_id, m1_0.id, m1_0.age, m1_0.email, m1_0.name
from member m1_0
where m1_0.team_id in (?, ?, ?, ?, ?, ?, ?, ?, ?, ?)   -- ② 회원을 한 번에
팀 팀1 회원 수: 2
팀 팀2 회원 수: 2
팀 팀3 회원 수: 2
4번이 2번이 됐다. 눈여겨볼 게 하나 있는데, 팀은 3개인데 IN 절 물음표가 10개다. 하이버네이트가 batch size 만큼 자리를 채운다. 실행 계획을 재사용하려는 것이라 정상이다.
설정 한 줄로 쿼리 수가 줄어든다. 공식 문서에서도 추천하는 방식이다.
전역 설정 대신 특정 연관관계에만 적용하려면 @BatchSize(size = 100) 를 필드나 클래스에 붙이면 된다.
보통은 yml 로 통일하지만, 유독 큰 컬렉션 하나만 다르게 주고 싶을 때 쓴다.
만능은 아닙니다.
여전히 쿼리가 여러 번 나가고(1 + batch 횟수), fetch join 처럼 1번으로 줄이진 못한다.
대신 fetch join 과 달리 페이징과 같이 써도 안전하다.
해결 2 — QueryDSL로 필요한 것만 딱 긁어오기
3편에서 다룬 QueryDSL 도 N+1 해결에 자주 쓴다.
fetch join 을 코드로 명시할 수도 있고, 필요한 필드만 DTO 로 뽑아 연관관계 접근 자체를 없앨 수도 있다.
queryFactory
    .selectFrom(team)
    .leftJoin(team.members, member).fetchJoin()
    .fetch();
조인해서 한 번에 가져오거나, 처음부터 Projections.constructor() 로 필요한 값만 DTO 로 조회하면 지연로딩을 건드릴 일이 없어진다.
자주 걸리는 함정이 하나 있다. 컬렉션을 fetch join 하면서 페이징을 같이 쓰면 안 된다. 하이버네이트가 페이징을 DB 가 아니라 메모리에서 처리하면서 HHH000104 경고를 남긴다. 데이터가 많으면 전부 메모리에 올라와 장애로 이어진다.
그래서 보통은 “컬렉션이 아닌 필드(ManyToOne, OneToOne)는 fetch join, 컬렉션(OneToMany)은 batch_fetch_size” 로 조합해서 씁니다.
정리
- N+1은 연관 엔티티를 지연로딩으로 하나씩 따로 조회하면서 발생
default_batch_fetch_size설정 한 줄로 IN 절 배치 조회로 쿼리 수를 확 줄일 수 있음 (페이징과도 궁합 좋음), 필드 단위로는@BatchSize- QueryDSL의 fetch join이나 DTO 프로젝션으로 아예 필요한 것만 한 번에 가져오는 것도 방법
- 단, 컬렉션 fetch join + 페이징 조합은 메모리 페이징으로 빠지는 함정이 있어서 피해야 함
JPA 개념(1편) → 영속성 컨텍스트·더티체킹(2편) → QueryDSL(3편) → N+1(4편)까지 왔다.