백엔드를 하면 JPA 를 안 쓸 수가 없는데, 막상 “JPA 가 정확히 뭐냐” 고 물으면 설명이 애매해진다.
개념부터 JPA Entity, Repository 기초, 그리고 첫날부터 마주치는 선택지들을 순서대로 정리해둔다.
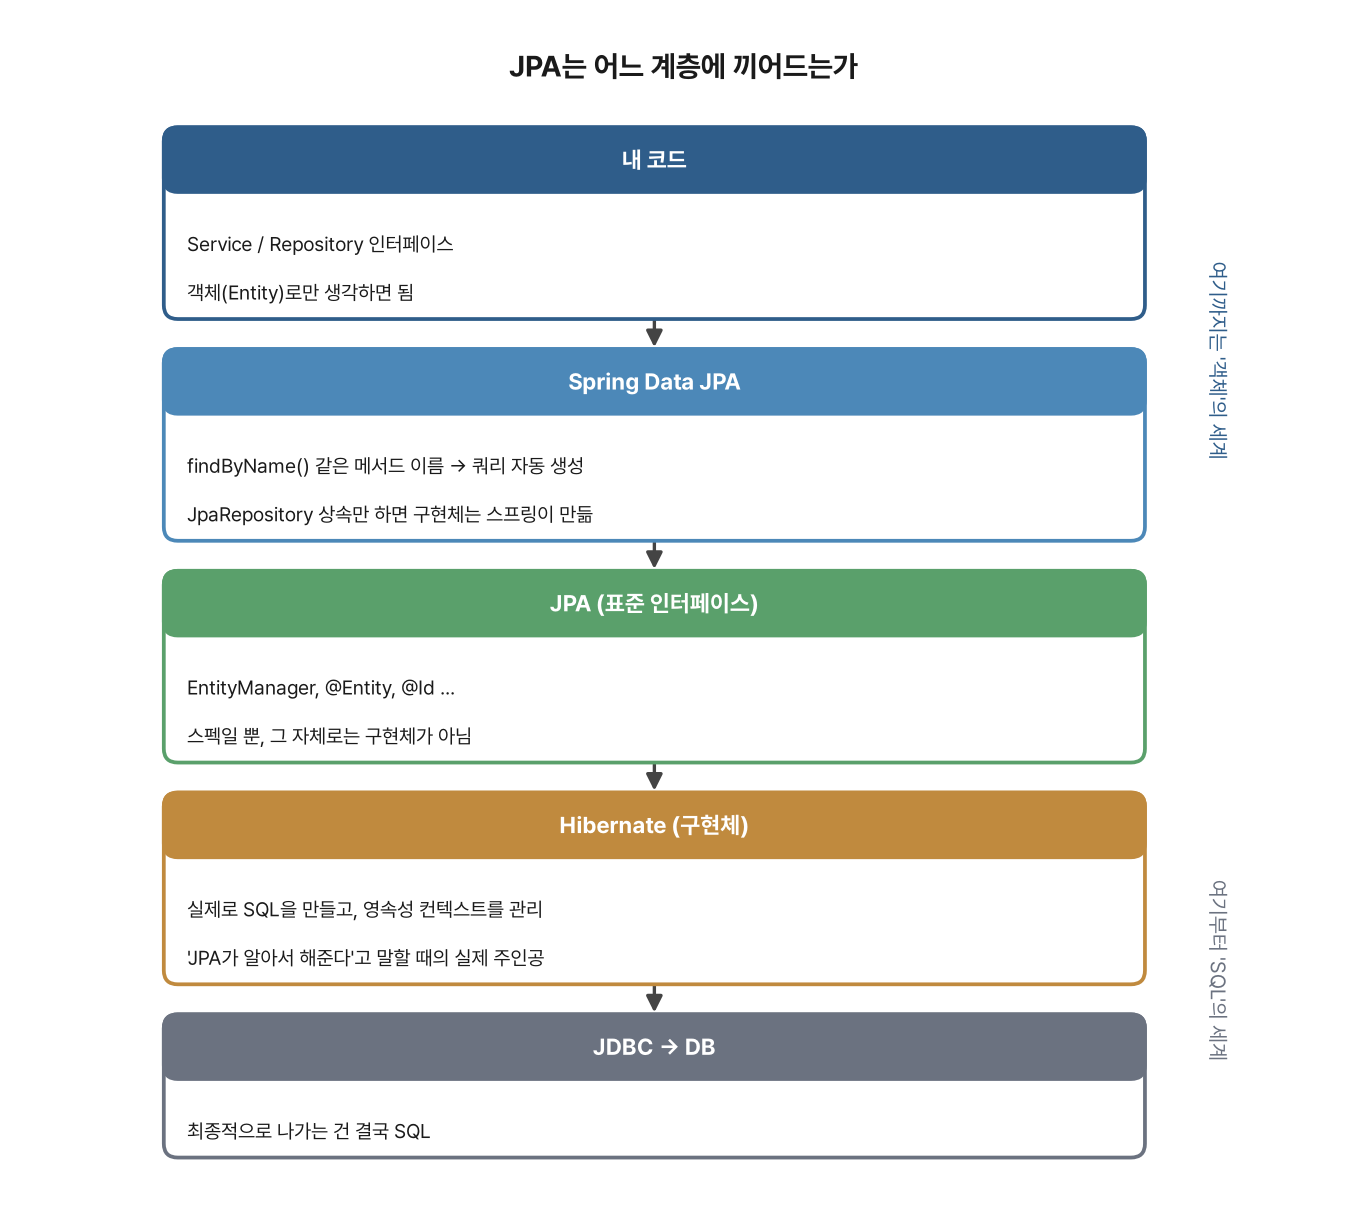
JPA란?
JPA(Java Persistence API)는 자바 진영의 ORM 표준 명세다. ORM(Object-Relational Mapping)은 객체와 관계형 DB 테이블을 매핑하는 기술이다.
핵심은 하나다. SQL 을 직접 짜는 대신 객체를 다루듯 DB 를 다룬다.
INSERT INTO member VALUES (...) 대신 member 객체를 저장하면 JPA 가 SQL 을 만들어 실행한다.
JPA 는 “명세” 일 뿐이라 실제 구현체가 필요하다. 그게 다음 편에서 다룰 하이버네이트(Hibernate)다.
JPA Entity — 객체를 테이블과 매핑하기
Entity 는 DB 테이블과 매핑되는 자바 클래스다. 어노테이션 몇 개만 붙이면 된다.
@Entity
@Table(name = "member")
public class Member {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(name = "name", nullable = false)
    private String name;

    @Column(name = "email")
    private String email;

    protected Member() {}

    public Member(String name, String email) {
        this.name = name;
        this.email = email;
    }
}
@Entity: 이 클래스가 JPA가 관리하는 엔티티라는 표시@Id: 기본키(PK) 지정@GeneratedValue: PK 생성 전략@Column: 컬럼 매핑 세부 설정 (이름, null 허용 여부 등)
기본 생성자를 protected 로 열어둔 건 습관이 아닙니다.
하이버네이트가 프록시를 만들거나 리플렉션으로 엔티티를 생성할 때 이 생성자를 쓴다. public 으로 열면 다른 사람이 new Member() 처럼 값 없이 만들어버릴 여지가 생긴다. 그래서 최소 범위만 연다.
PK 생성 전략, 실무에서는 뭘 써야 할까
@GeneratedValue 의 strategy 는 대충 고르면 나중에 후회한다. 자주 쓰는 네 가지는 이렇다.
IDENTITY 는 DB 의 auto_increment 에 위임한다. 설정이 간단하고 MySQL 과 궁합이 좋은데, INSERT 전에 PK 를 알 수 없어 쓰기 지연 최적화를 못 받는다. MySQL 이면 사실상 기본 선택이다.
SEQUENCE 는 DB 시퀀스에서 번호를 미리 받아온다. INSERT 전에 PK 를 알 수 있어 쓰기 지연이 가능하고 allocationSize 로 튜닝도 된다. 대신 시퀀스를 지원하는 DB(Oracle, PostgreSQL)에서만 쓸 수 있다.
TABLE 은 키 생성 전용 테이블을 따로 둔다. 모든 DB 에서 동일하게 동작하지만 그 테이블에 락이 걸려 성능 이슈가 난다. 실무에서 거의 안 쓴다.
AUTO 는 하이버네이트가 DB 방언을 보고 알아서 고른다. 신경 안 써도 되는 대신 어떤 전략이 적용되는지 안 보여서 예측이 어렵다. 학습용이 아니면 비추천입니다.
IDENTITY 의 “쓰기 지연을 못 받는다” 는 게 실무에서 은근히 중요하다.
하이버네이트는 원래 save() 를 호출해도 바로 INSERT 하지 않고 트랜잭션 커밋 시점까지 모아둔다. 그런데 IDENTITY 는 DB 가 값을 만들어줘야 PK 를 알 수 있어서 save() 즉시 INSERT 가 나간다.
대량 저장에서 벌크 insert 최적화를 하려면 이걸 염두에 둬야 한다.
Repository — DB 접근을 인터페이스 하나로
순수 JPA 만 쓰면 EntityManager 로 CRUD 를 직접 짜야 한다. Spring Data JPA 를 쓰면 인터페이스 하나만 정의해도 기본 CRUD 가 만들어진다.
public interface MemberRepository extends JpaRepository<Member, Long> {

    Optional<Member> findByEmail(String email);

    List<Member> findByNameContaining(String keyword);

    @Query("select m from Member m where m.name = :name and m.email like %:domain")
    List<Member> findByNameAndEmailDomain(@Param("name") String name, @Param("domain") String domain);
}
JpaRepository<Member, Long> 을 상속하면 save(), findById(), findAll(), delete() 가 따라온다. findByEmail 처럼 이름 규칙만 지키면 구현 없이 쿼리가 만들어진다.
다만 메서드 이름 쿼리는 조건이 서너 개만 넘어가도 이름이 감당이 안 된다(findByNameAndEmailAndAgeGreaterThanAndStatus 같은 식). 조금만 복잡해지면 @Query 로 JPQL 을 직접 쓰거나 QueryDSL 로 넘어간다.
판단 기준은 3편에서 짚는다.
정리
- JPA는 ORM 표준 명세, 객체 중심으로 DB를 다루게 해줌
- Entity는 어노테이션으로 테이블과 매핑되는 클래스, 기본 생성자는
protected로 - PK 생성 전략은 DB에 맞춰서(MySQL은 IDENTITY, PostgreSQL/Oracle은 SEQUENCE) 명시적으로 고르기
- Repository(Spring Data JPA)는 반복적인 CRUD 코드를 없애주지만, 조건이 복잡해지면
@Query나 QueryDSL로 넘어가는 게 맞음
다음 편은 영속성 컨텍스트와 더티체킹, 그리고 하이버네이트가 실제로 뭘 하는지다.
참고
JPA 시리즈 전체 보기
- 1편 — JPA Entity, Repository 기초 정리 (지금 보는 글)
- 2편 — 영속성 컨텍스트와 더티체킹 완전정리
- 3편 — QueryDSL 동적 쿼리 깔끔하게 짜기
- 4편 — JPA N+1 문제 해결법 3가지
- 5편 — JPA OSIV, 기본값 true의 성능 함정
- 6편 — @ManyToMany 대신 중간 엔티티 쓰기
- 7편 — Cascade·@Transactional 함정
- 8편 — JPA 상속 관계 매핑 전략 3가지 비교