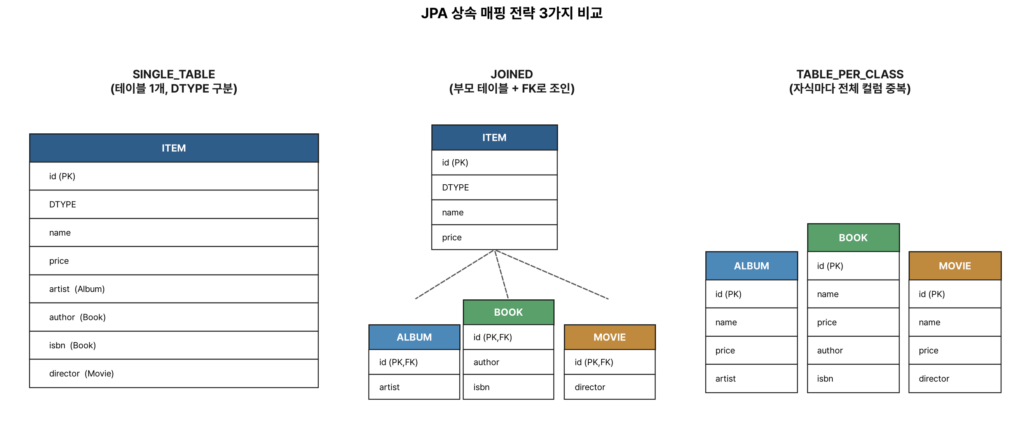
JPA 상속 관계 매핑 전략 3가지 비교 (8편)
JPA 상속 관계 매핑 전략인 SINGLE_TABLE, JOINED, TABLE_PER_CLASS 를 각각 H2 에 올려 테이블이 몇 개 생기고 어떤 쿼리가 나가는지 직접 찍어봤다. JOINED 의 case 문과 TABLE_PER_CLASS 의 UNION ALL 까지.
JPA를 실무에서 쓰면서 겪은 문제와 해결 과정을 8편 시리즈로 정리했습니다. 영속성 컨텍스트, N+1, OSIV, Cascade, 상속 매핑까지 예제 코드와 함께 다룹니다.
JPA 상속 관계 매핑 전략인 SINGLE_TABLE, JOINED, TABLE_PER_CLASS 를 각각 H2 에 올려 테이블이 몇 개 생기고 어떤 쿼리가 나가는지 직접 찍어봤다. JOINED 의 case 문과 TABLE_PER_CLASS 의 UNION ALL 까지.
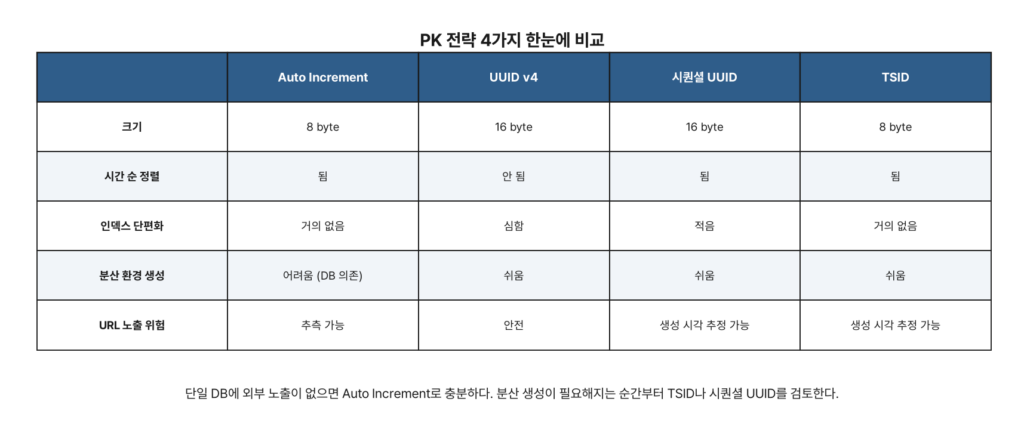
Auto Increment 로 충분한 줄 알았는데 MSA 에서 PK 가 겹쳤다. PK 전략 비교를 처음부터 다시 했다. UUID 가 인덱스를 망가뜨리는 두 가지 이유와 TSID, 그리고 이미 만든 테이블은 어떻게 할지.
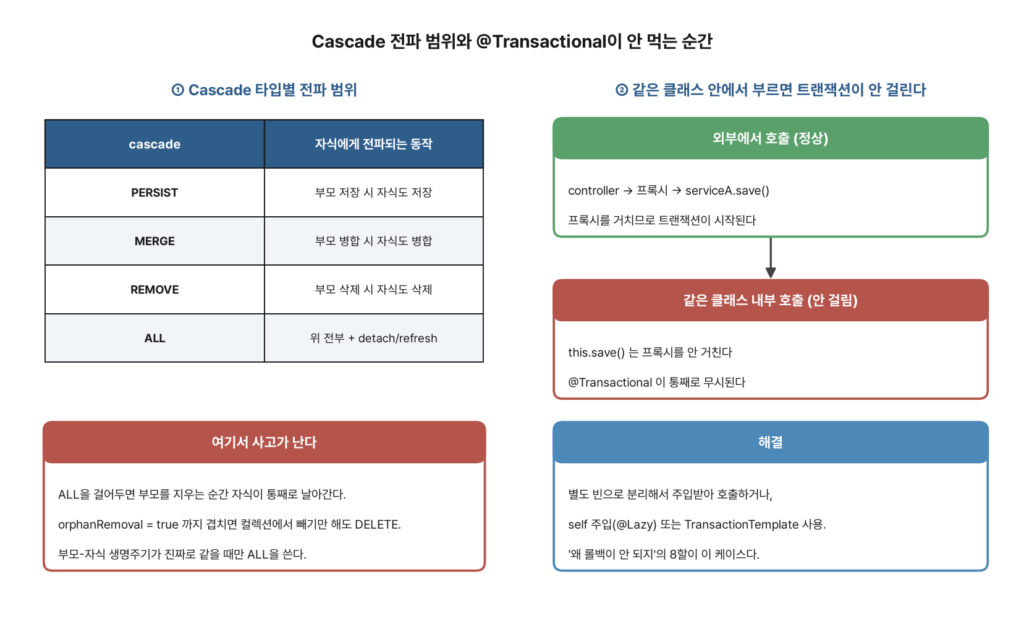
cascade 에 습관적으로 ALL 을 박으면 부모 삭제가 자식까지 전이된다. delete 한 번에 DELETE 3번 나가는 로그와, 같은 클래스 내부 호출에서 @Transactional 이 안 먹는 이유.
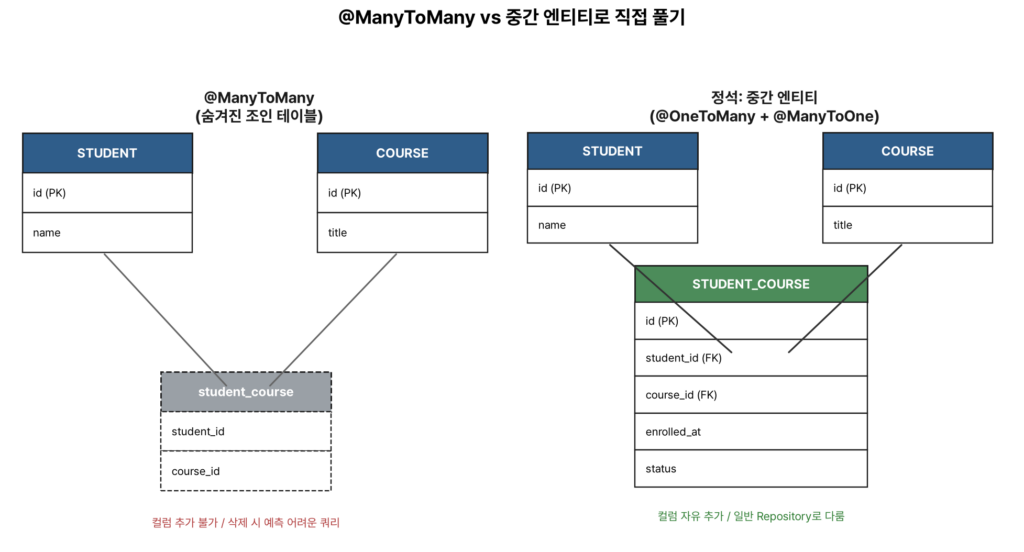
@ManyToMany 대신 중간 엔티티를 쓰는 이유. 컬럼 추가가 안 되고 쿼리도 예측이 안 된다. 조인 컬럼명이 courses_id 로 나오는 실제 로그와 함께, 중간 엔티티로 푸는 정석을 정리했다.
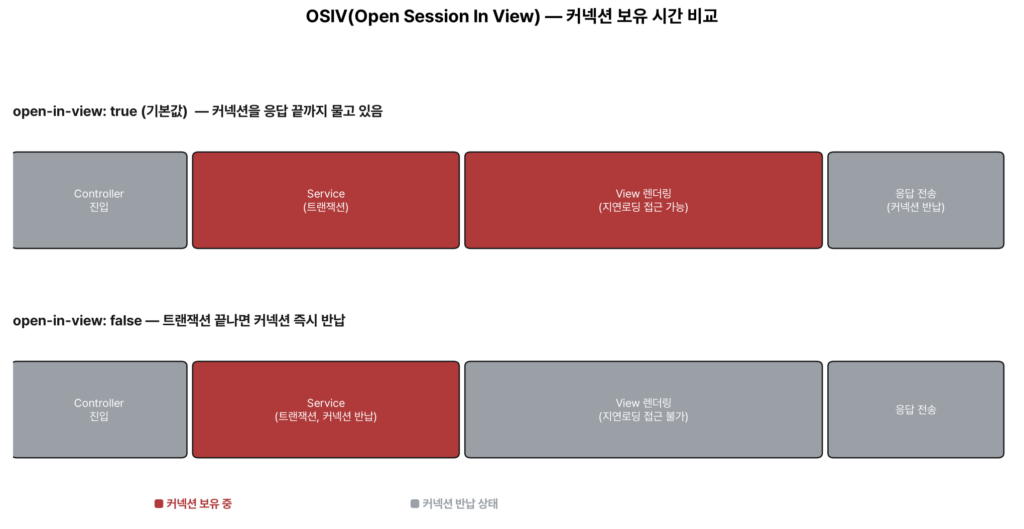
스프링 부트 기본값이라 그냥 쓰고 있었던 JPA OSIV, 사실 트래픽 몰리면 커넥션 풀 고갈로 장애까지 이어질 수 있는 옵션이었어요. 꺼야 할지 말지 실무 기준까지 정리해봤습니다.
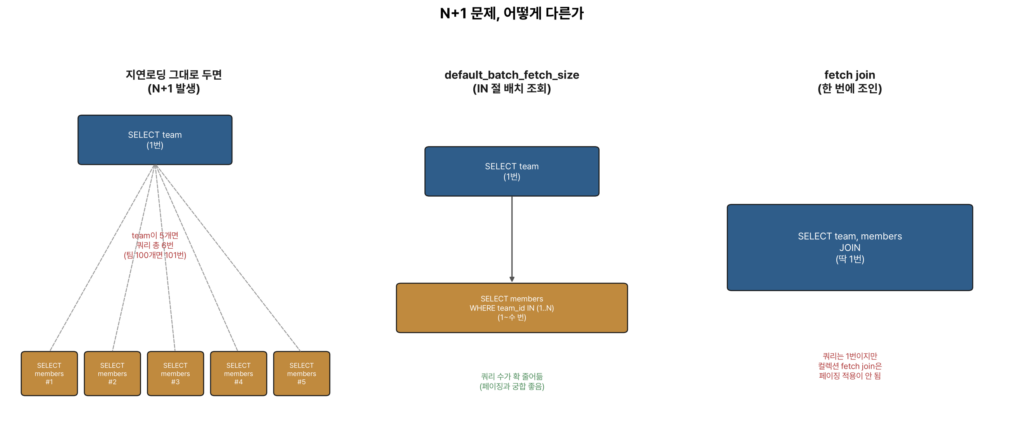
findAll() 한 번에 SELECT 가 우르르 나가는 이유와 JPA N+1 문제 해결 방법 세 가지. 팀 3개에 쿼리 4번 나가는 로그부터 batch_fetch_size 로 2번이 되는 로그까지 직접 찍어서 실었다.
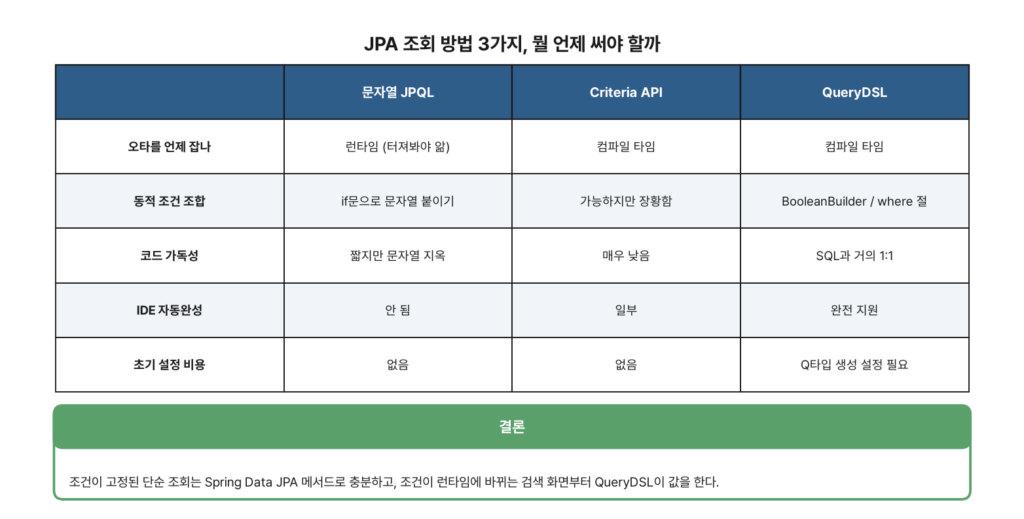
메서드 이름 쿼리, @Query, QueryDSL 동적 쿼리 중 뭘 쓸지 고민된다면. null 조건이 where 에서 빠지는 걸 실제 SQL 로그로 확인했고, 페이징 count 쿼리 분리까지 정리했다.
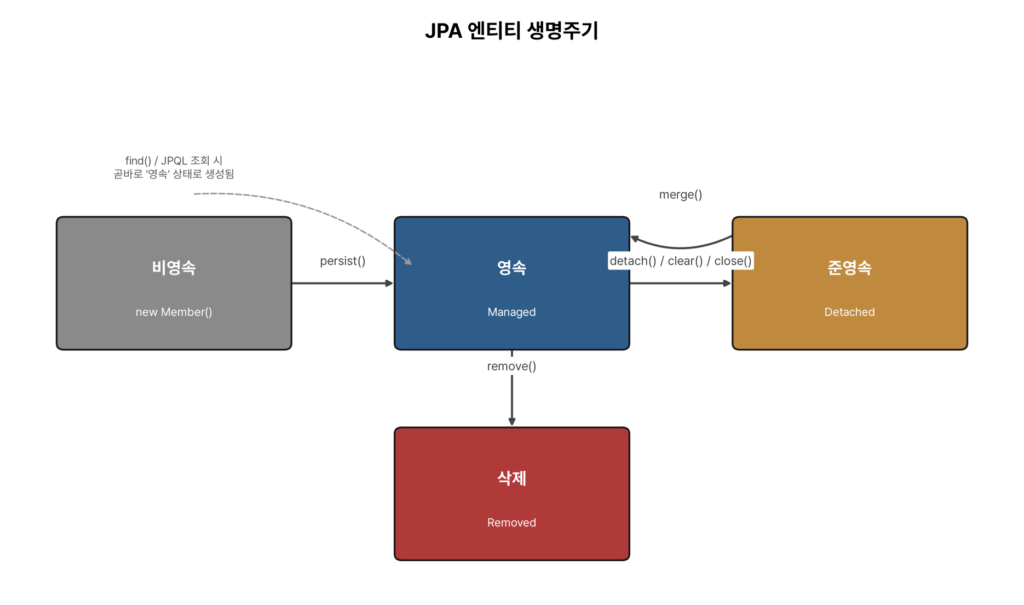
setter 만 호출했는데 UPDATE 쿼리가 나간다. 영속성 컨텍스트와 더티체킹 원리, 하이버네이트가 실제로 뭘 하는지 정리했다. 실제 실행 로그도 같이 실었다.
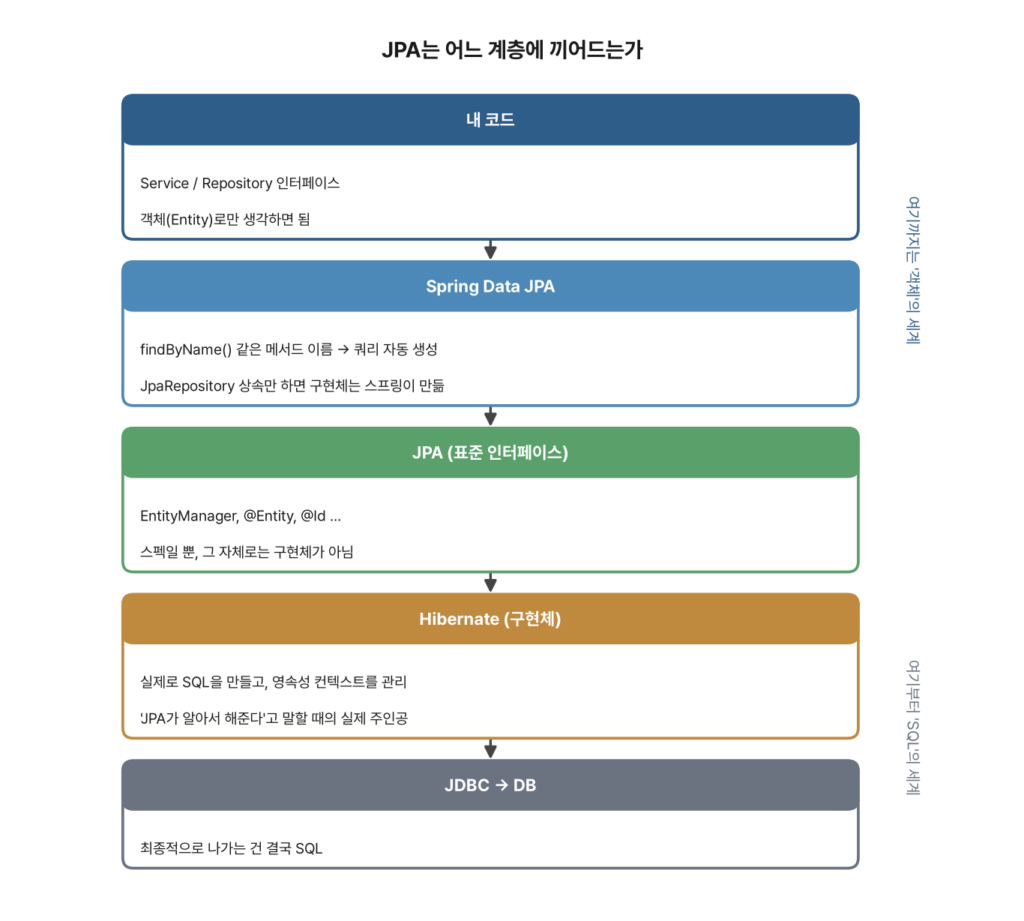
JPA가 정확히 뭔지 애매하게 알고 있었다면 여기서 정리하세요. JPA Entity 기본 생성자를 protected로 두는 이유, PK 생성 전략(IDENTITY vs SEQUENCE) 실무 기준, Repository 메서드 이름 쿼리의 한계까지 첫날 마주치는 선택지들 순서대로 짚었습니다.